robots.txtの書き方|記述例と置く場所・確かめ方、noindexとの違い
公開
検索結果に出したくないページを robots.txt の Disallow で止めたのに、検索結果に説明文の無い URL が表示されたままになることがあります。反対に、確認用の環境で使っていた Disallow: / が公開後も残り、サイト全体のクロールが止まる失敗もあります。robots.txt は数行のテキストですが、/ の1文字の有無でクロールの範囲が正反対になるファイルです。
株式会社メリルが運営する5つのドメインの robots.txt を取得して並べると、同じ WordPress のサイトでもプラグインによって書かれた行が違い、AI のクローラーを名指ししたドメインは1つもありませんでした。この記事では、robots.txt の書き方を記述例で示し、置く場所、確かめ方、noindex との違い、AI のクローラーの扱いを解説します。
記事を読めば、自社サイトの robots.txt を書き、公開した後に効いているかを確かめられます。robots.txt にはクロールさせたくない場所だけを書き、検索結果から外したいページには noindex を使うのが基本です。
robots.txtの書き方は4種類の行を組み合わせる
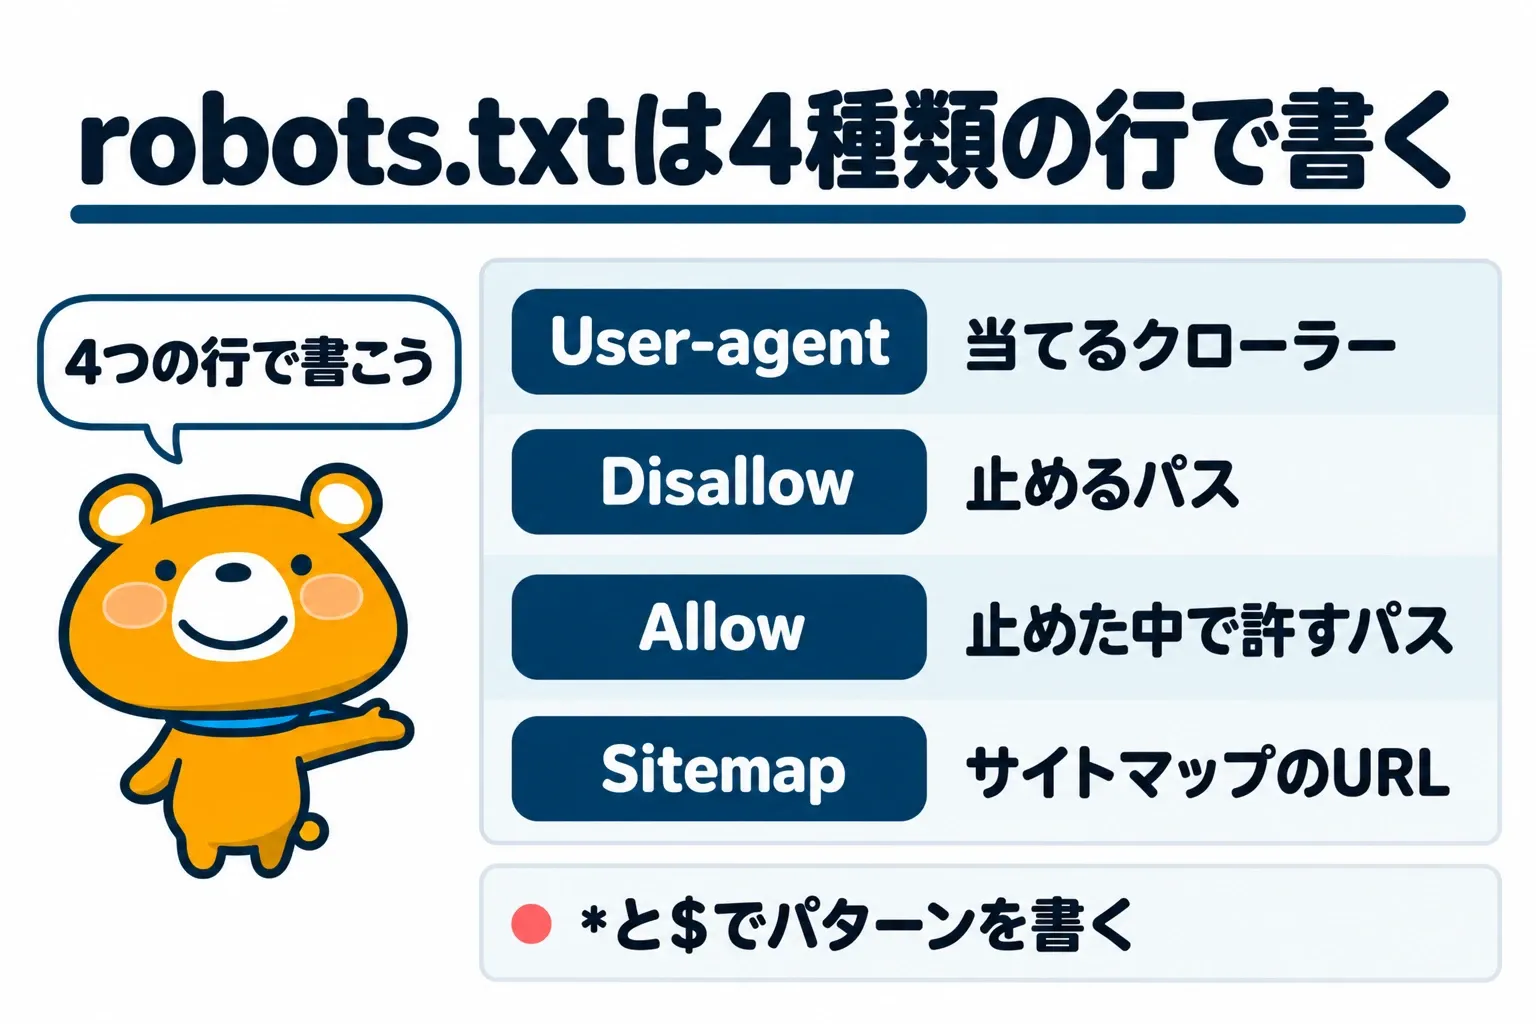
robots.txt は、どのクローラーに、サイトのどのパスをクロールさせないかを書くテキストファイルです。Google が読む行は User-agent・Disallow・Allow・Sitemap の4種類で、crawl-delay などのほかの行は読みません。4種類の行の書き方は、以下のとおりです。
- User-agentの行でルールを当てるクローラーを決める
- DisallowとAllowでクロールさせないパスを書く
- Sitemapの行にサイトマップの完全なURLを書く
- *と$でパスのパターンを書く
User-agentの行でルールを当てるクローラーを決める
robots.txt のルールは、User-agent の行から始まるグループの単位で書きます。User-agent に * を書いたグループが当たるのは、名指しされていないクローラーすべてです。
User-agent: Googlebot
Disallow: /nogooglebot/

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
上の例では、Googlebot だけが /nogooglebot/ から始まる URL をクロールできず、ほかのクローラーはサイト全体をクロールできます。User-agent の値は、大文字と小文字を区別しません。
1つのクローラーに当たるのは、名前が最も限定的に一致した1つのグループだけです。Googlebot を名指ししたグループがあれば、Googlebot は * のグループのルールを読みません。名指ししたグループにも、* のグループと同じ制限が要るかを確かめて書き足します。
DisallowとAllowでクロールさせないパスを書く
Disallow にはクロールさせないパスを書き、Allow には Disallow で止めた中でクロールを許すパスを書きます。パスはドメインより後ろの部分で、先頭は / です。フォルダを指すときは、末尾にも / を付けます。
WordPress が返す robots.txt は、Disallow と Allow を組み合わせた例です。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
/wp-admin/admin-ajax.php は、2つのルールの両方に当てはまります。Google は当てはまったルールのうちパスの長いほうを使うため、admin-ajax.php だけがクロールでき、ほかの /wp-admin/ の下は止まります。長さが同じルールがぶつかったときに使われるのは、制限の少ない Allow です。
ルールのパスは、大文字と小文字を区別します。Disallow: /file.asp は /FILE.asp には効きません。
Sitemapの行にサイトマップの完全なURLを書く
Sitemap の行には、サイトマップの場所を https:// から始まる完全な URL で書きます。Sitemap の行はクローラーの名前と結び付かないため、複数の行をファイルの最後にまとめて書けます。
Sitemap: https://example.com/sitemap.xmlGoogle は、http と https の違いや www の有無を補って読みません。書く URL は、サイトで使っている形にそろえます。
*と$でパスのパターンを書く
ルールのパスには、0文字以上の任意の文字を表す * と、URL の末尾を表す $ の2つの記号を使えます。記号の使い方と、当てはまる URL の例は以下の表のとおりです。
| ルールのパス | 当てはまる URL | 当てはまらない URL |
|---|---|---|
/fish |
/fish・/fish.html・/fishheads | /Fish.asp・/catfish |
/fish/ |
/fish/・/fish/salmon.htm | /fish・/fish.html |
/*.php |
/index.php・/folder/filename.php?parameters | /windows.PHP |
/*.php$ |
/filename.php・/folder/filename.php | /filename.php?parameters |
/$ |
トップページだけ | トップページより下の URL |
末尾の * は無視されるため、/fish* は /fish と同じ意味になります。$ を付けたルールが当たらないのは、パラメータ付きの URL です。たとえば /cats.xls?personality=loki は、Disallow: /*.xls$ では止まりません。
目的別のrobots.txtの記述例
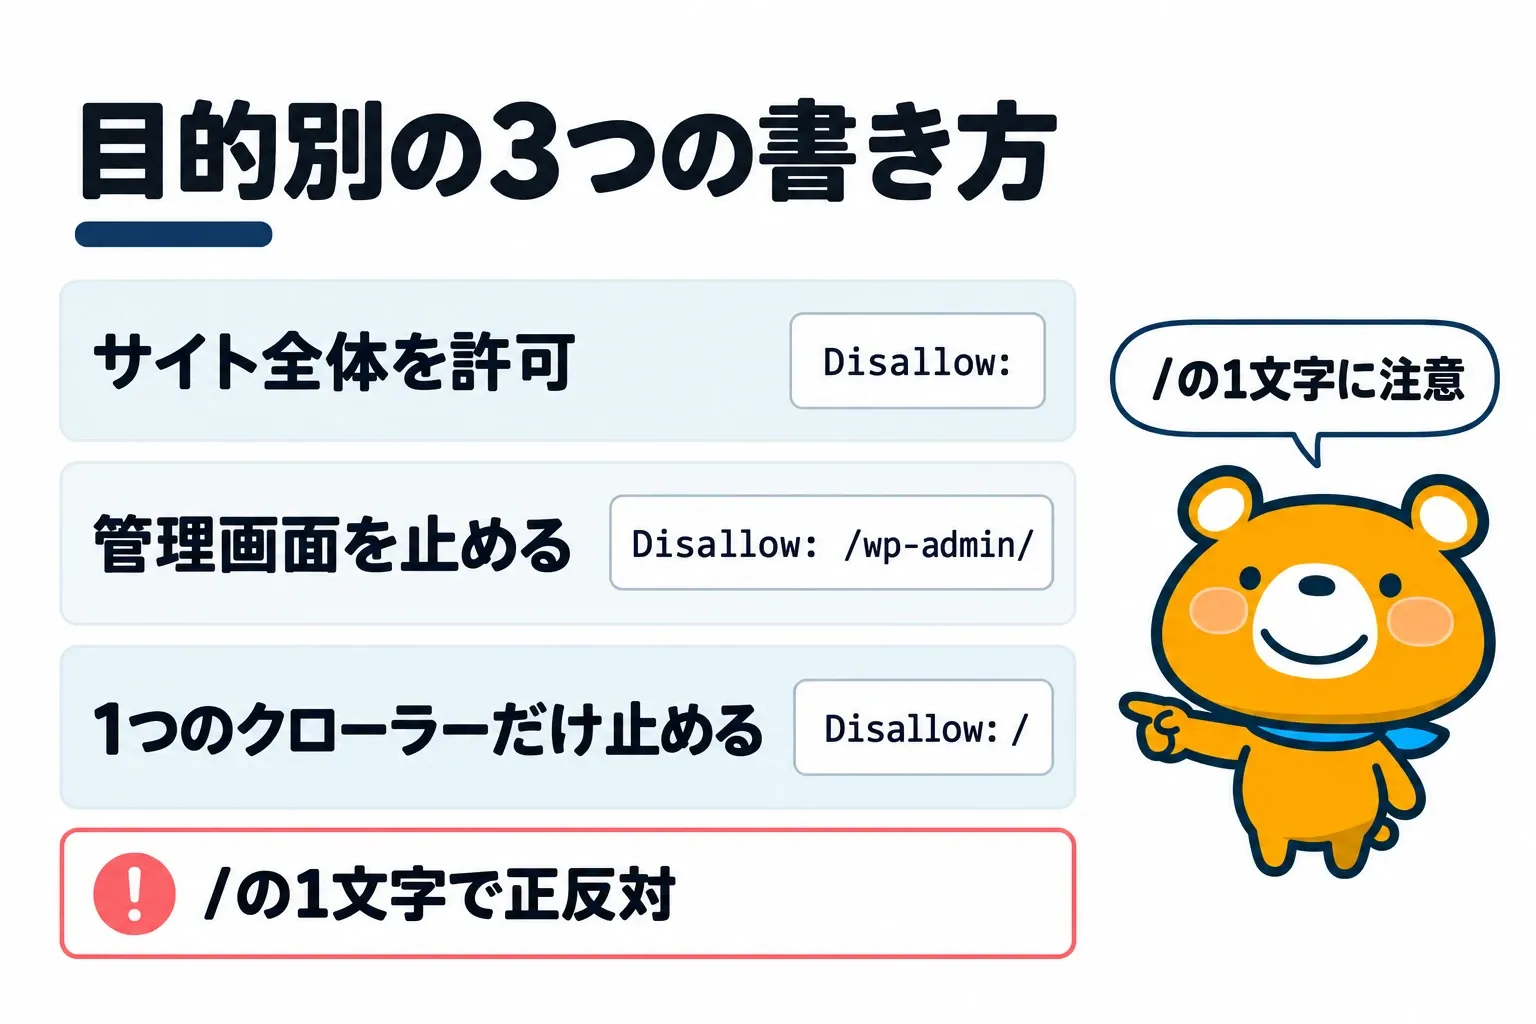
robots.txt に書く中身は、クロールを止めたい場所によって変わります。3つの場面の書き方は、以下のとおりです。
- サイト全体のクロールを許可する
- 管理画面などのフォルダとページのクロールを止める
- 特定のクローラーだけクロールを止める
サイト全体のクロールを許可する
止めたい場所が無いサイトは、サイト全体のクロールを許可する2行で足ります。値を空にした Disallow の行は、何も止めません。
User-agent: *
Disallow:
上の2行は、Allow: / を書いた場合とも、robots.txt を置かない場合とも同じ働きをします。Disallow: と Disallow: / は / の1文字の違いですが、Disallow: / はサイト全体のクロールを止める行です。
メリルの自社ドメインでも、両方の書き方が使われていました。WordPress で動く bfb-plugin.com は、プラグインの Yoast SEO が書き込んだ空の Disallow の形です。Astro で作った meril.co.jp は、Allow: / の形です。
管理画面などのフォルダとページのクロールを止める
クロールさせる必要の無いフォルダは、フォルダ名の後ろに / を付けて Disallow に書きます。1ページだけ止めるときに書くのは、ファイル名までのパスです。
User-agent: *
Disallow: /calendar/
Disallow: /junk/other_useless_file.html
メリルが運営する WordPress のドメインのうち3つ(blog-soudan.com・blogrank.jp・meril-theme.com)も、Disallow で止めているのは管理画面の /wp-admin/ のフォルダだけです。
特定のクローラーだけクロールを止める
1つのクローラーだけを止めるときは、止めたいクローラーの名前のグループに Disallow: / を書き、* のグループでほかのクローラーを許可します。
User-agent: Unnecessarybot
Disallow: /

User-agent: *
Allow: /
複数のクローラーに同じルールを当てるときは、User-agent の行を続けて書けば1つのグループにまとめられます。
robots.txtを置く場所はドメインのルート
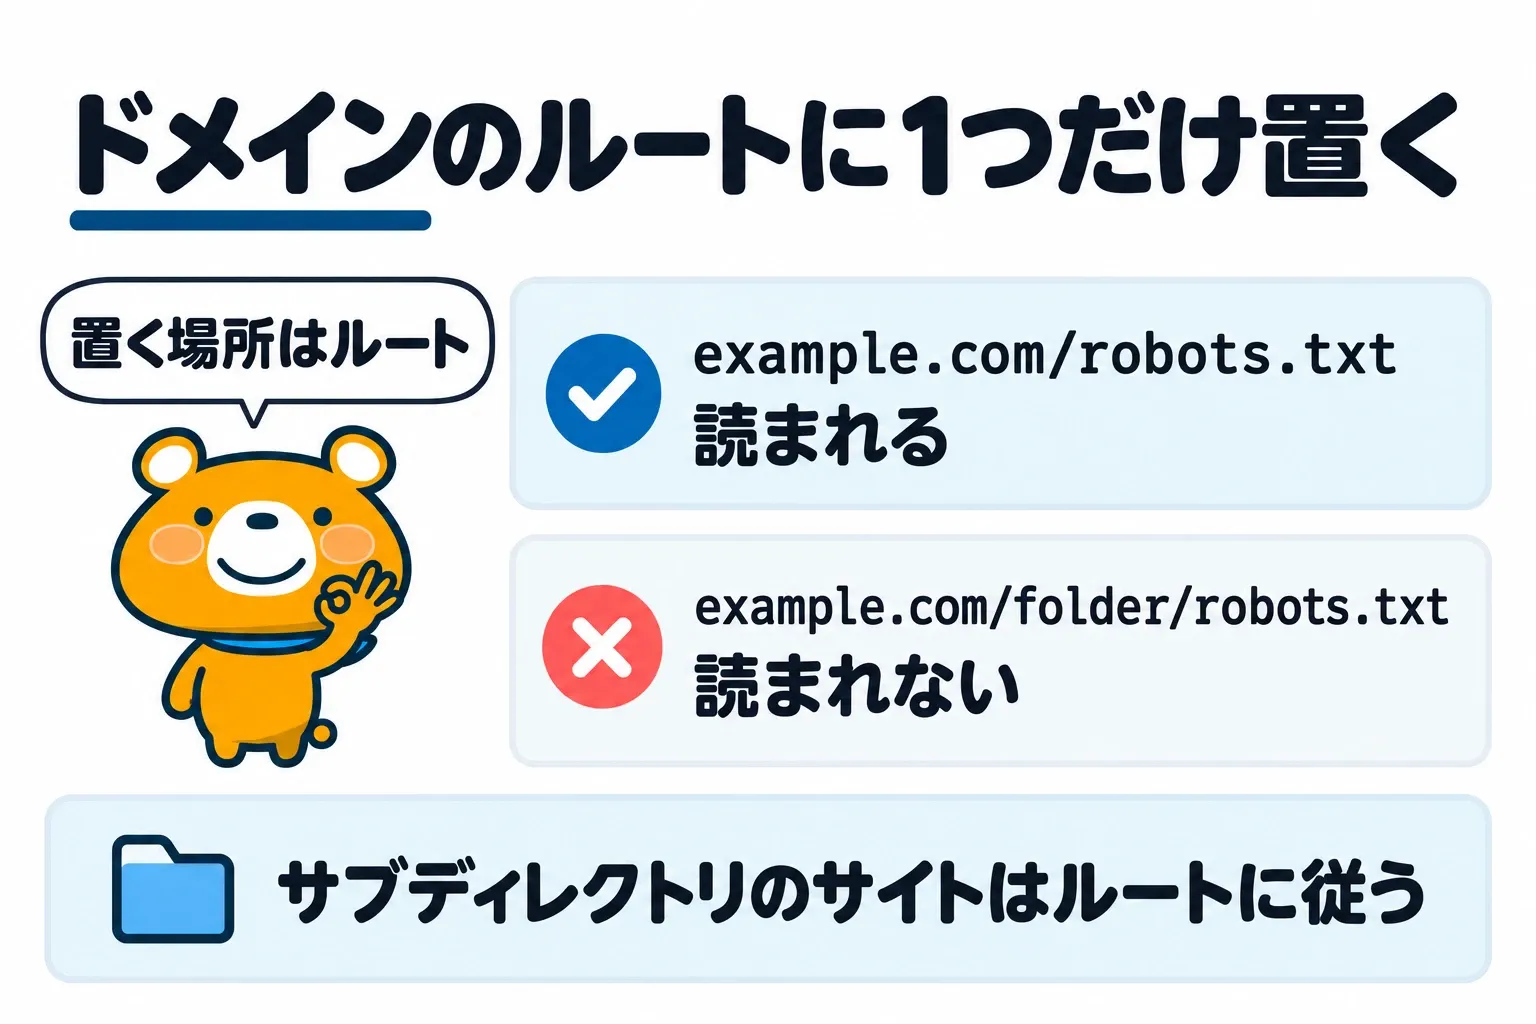
robots.txt は、置く場所を間違えるとクローラーに読まれません。置く場所について押さえることは、以下の3つです。
- robots.txtはドメインのルートに1つだけ置く
- サブディレクトリに置いたサイトはルートのrobots.txtに従う
- WordPressとAstroではrobots.txtの作られ方が違う
robots.txtはドメインのルートに1つだけ置く
robots.txt は、robots.txt という名前のテキストファイルにして、ドメインのいちばん上のフォルダ(ルート)に置きます。https://example.com/ のサイトなら、URL は https://example.com/robots.txt です。
robots.txt が効く範囲は、置いたファイルと同じプロトコル・ホスト・ポートの URL だけです。https://example.com/robots.txt のルールは、http://example.com/ や https://m.example.com/ には効きません。サブドメインを使うサイトでは、サブドメインごとに robots.txt を置きます。
ファイルは、ワープロソフトではなくテキストエディタで作り、UTF-8 で保存します。
サブディレクトリに置いたサイトはルートのrobots.txtに従う
https://example.com/folder/robots.txt のようにサブディレクトリに置いたファイルは、robots.txt として読まれません。サイトをドメインのサブディレクトリに置いている場合、クロールのルールを決めるのはドメインのルートの robots.txt です。ルートのファイルを書き換える権限が無ければ、ドメインの管理者に変更を頼みます。
メリルが運営するメディアのうち、次の3つはドメインのサブディレクトリに置いた Astro のサイトです。
- WWS メディア(wwstd.jp/media/)
- Web集客ブック(hands-plus.com/media/)
- オウンドメディア相談室(blog-soudan.com/owned-media/)
オウンドメディア相談室のクロールのルールは、blog-soudan.com のルートの robots.txt で決まります。ルートの robots.txt は掲示板の WordPress が返すもので、止めているのは /wp-admin/ だけです。2026年10月30日に確かめると、/owned-media/ の下はクロールが許可されていました。
ルートの robots.txt に Sitemap の行を足せないサイトは、サーチコンソールのサイトマップ レポートからサイトマップを送信します。メリルは2026年10月30日に、Web集客ブックのサイトマップをサーチコンソールから送信しました。
WordPressとAstroではrobots.txtの作られ方が違う
robots.txt は、ファイルを置くか、CMS などが作って返すかで、書き換える場所が変わります。メリルが運営する5つのドメインの robots.txt を2026年10月30日に取得すると、User-agent の行はどれも * の1行で、Disallow と Allow の行は以下の表のとおりでした。
| ドメイン | サイトの作り | Disallow | Allow |
|---|---|---|---|
| blog-soudan.com | WordPress | 1行(/wp-admin/) | 1行 |
| blogrank.jp | WordPress | 1行(/wp-admin/) | 1行 |
| meril-theme.com | WordPress | 1行(/wp-admin/) | 1行 |
| bfb-plugin.com | WordPress(Yoast SEO) | 1行(値は空) | なし |
| meril.co.jp | Astro | なし | 1行(/) |
WordPress は、User-agent: *・Disallow: /wp-admin/・Allow: /wp-admin/admin-ajax.php の3行を robots.txt として返し、プラグインが行を書き足したり書き換えたりできる作りになっています。
Astro で robots.txt を作る方法は、public フォルダにファイルを置くか、src/pages/robots.txt.ts のコードで作るかの2つです。meril.co.jp はコードで作っており、公式のドメイン向けにビルドしたときだけ Allow: / と Sitemap の行を出し、それ以外のビルドでは Disallow: / を出します。
» サイトリニューアルのSEOは転送の対応表で守る|注意点と前後の比べ方
robots.txtが効いているかの確かめ方
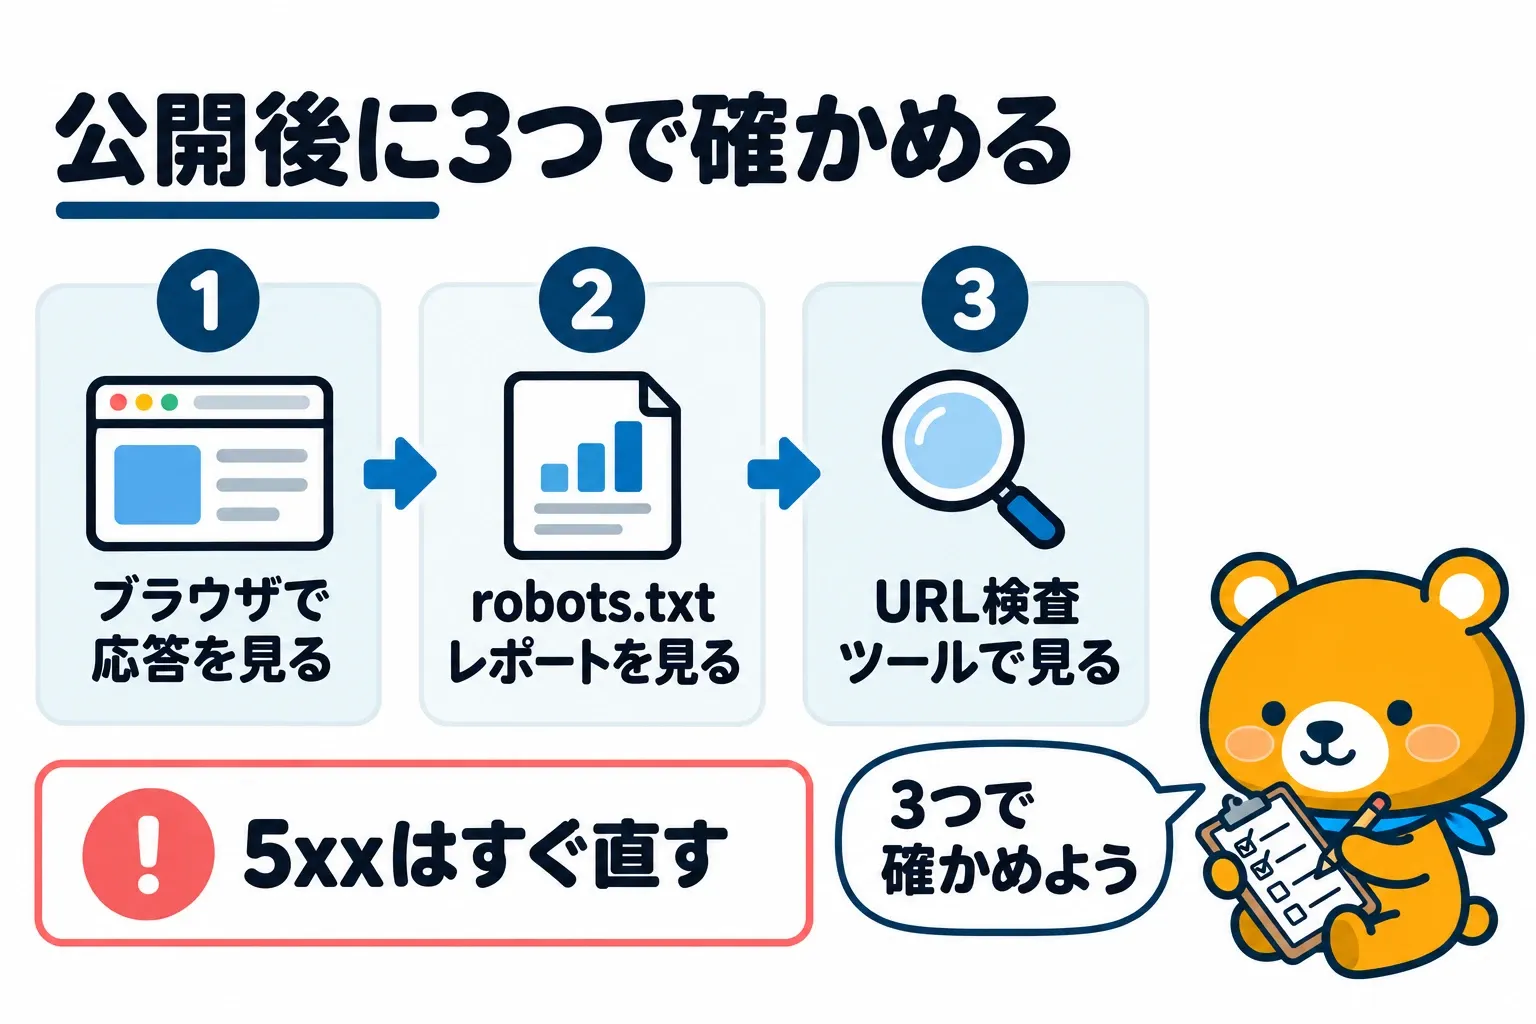
robots.txt は、アップロードしただけでは、意図どおりに読まれているかがわかりません。公開した後に確かめる方法は、以下の3つです。
- ブラウザでrobots.txtのURLを開いて応答を見る
- サーチコンソールのrobots.txtレポートで取得の状態を見る
- URL検査ツールでページが止まっていないかを見る
ブラウザでrobots.txtのURLを開いて応答を見る
アップロードした robots.txt は、ブラウザのシークレット ウィンドウで https://(ドメイン)/robots.txt を開いて中身を確かめます。中身と一緒に見ておきたいのが、サーバーが返す応答の番号です。Mac のターミナルなら、次の1行で応答の番号と中身を表示できます。
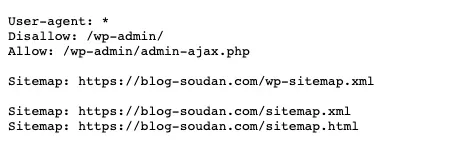
blog-soudan.com のルートの robots.txt(https://blog-soudan.com/robots.txt)をブラウザで開いた画面(2026年10月31日)。ドメインのルートで動いている掲示板(WordPress)が出しているファイルです。
curl -i https://example.com/robots.txtGoogle の扱いは、robots.txt の応答の番号ごとに次のとおりです。
- 200: 書かれたルールを読む
- 429 以外の4xx(404 など): robots.txt が無いものとして、クロールを制限しない
- 5xx: 最初の12時間はサイトのクロールを止め、その後は30日まで前回取得できた版を使う
5xx を返す状態は、早く直す必要があります。robots.txt を返すサーバーのエラーが続くと、ページそのものに問題が無くてもサイトのクロールが止まるためです。
サーチコンソールのrobots.txtレポートで取得の状態を見る
サーチコンソールの robots.txt レポートでは、Google が見つけた robots.txt と前回のクロールの日時、警告やエラーを確かめられます。取得ステータスが「取得済み」なら、Google が robots.txt を読めている状態です。
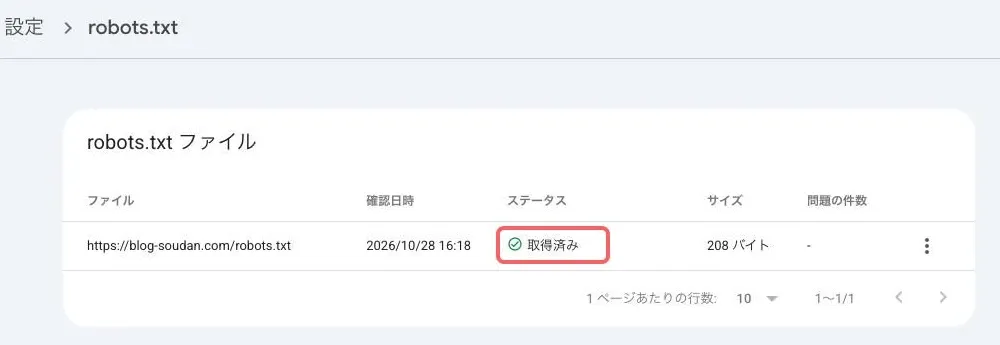
出典:Google Search Console の robots.txt レポート(オウンドメディア相談室が使っている blog-soudan.com のプロパティ。2026年10月31日の画面)。Google Search Console は Google LLC の商標です。オウンドメディア相談室は、Google が推奨・提携しているものではありません。
オウンドメディア相談室が置かれている blog-soudan.com では、2026年10月31日の時点で、Google が前回 robots.txt を確かめたのは10月28日16時18分でした。ステータスは「取得済み」で、サイズは208バイトと、サーバーが返す robots.txt の大きさ(208バイト)と同じでした。
robots.txt レポートを使えるのは、ドメイン プロパティと、パスの無い URL プレフィックス プロパティだけです。https://example.com/media/ のようにパスを含むプロパティでは使えません。メリルが Web集客ブックで登録したのもパスを含む https://hands-plus.com/media/ のプロパティで、robots.txt レポートの対象外です。
Google は、robots.txt のキャッシュを24時間おきに更新しています。重要な URL のブロックを外したときや、取得のエラーを直したときは、レポートの「再クロールをリクエスト」から読み直しを頼めます。リクエストしても、ブロックを外した URL がすぐにクロールされるとは限りません。
URL検査ツールでページが止まっていないかを見る
1つのページが robots.txt で止まっているかは、サーチコンソールの URL 検査ツールで確かめます。ページの URL を入れて調べ、「クロールを許可?」の欄が「いいえ」なら、robots.txt のルールでクロールが止まっています。
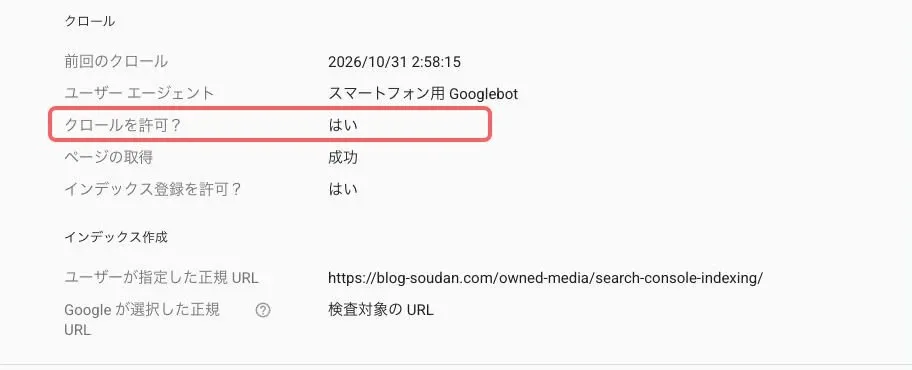
出典:Google Search Console のURL 検査ツール(オウンドメディア相談室が使っている blog-soudan.com のプロパティ。2026年10月31日の画面)。調べたのはこのメディアの記事の URL です。Google Search Console は Google LLC の商標です。オウンドメディア相談室は、Google が推奨・提携しているものではありません。
robots.txt を書き換えた後は、止めたいページと、止めてはいけないページの両方を検査しましょう。ルールが広すぎると、止めてはいけないトップページや記事のページまで止まっていることがあります。
» サーチコンソールのインデックス登録リクエスト手順|読み込まれたかの確かめ方
robots.txtとnoindexの違いと使い分け
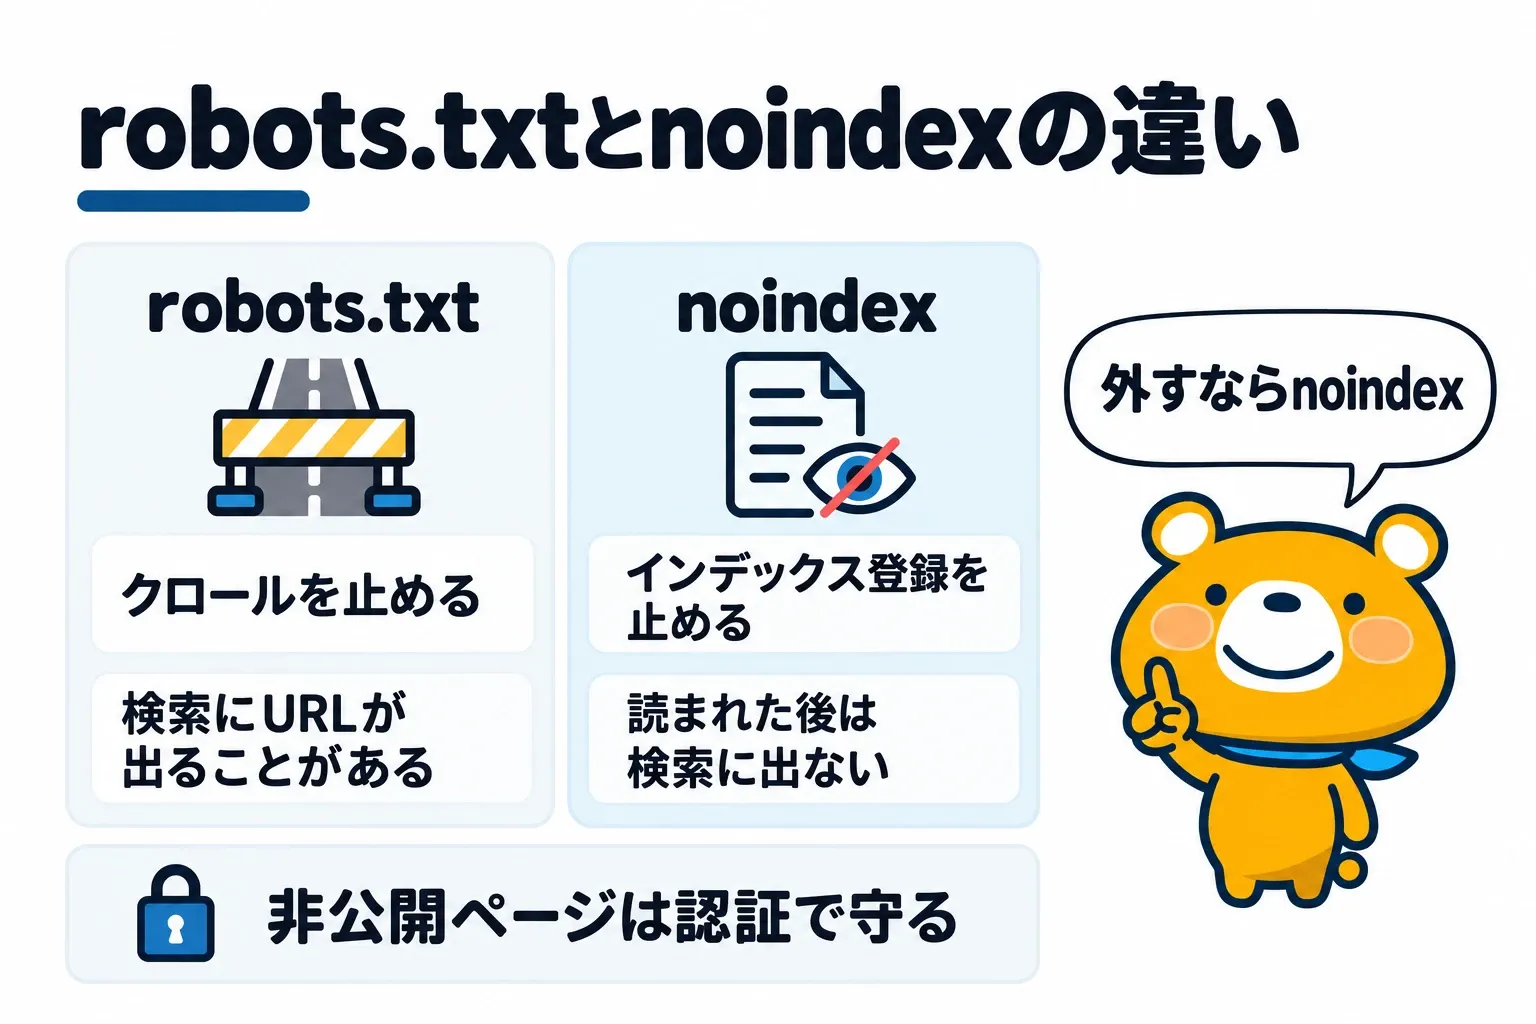
robots.txt はクロールを止めるファイルで、ページを検索結果から外すしくみではありません。robots.txt と noindex の違いは、以下の表のとおりです。
| 項目 | robots.txt | noindex |
|---|---|---|
| 止めるもの | クロール | インデックスへの登録 |
| 書く場所 | ドメインのルートのファイル | ページの meta タグか HTTP のレスポンス ヘッダー |
| 単位 | パス(フォルダごとにも書ける) | ページ |
| 検索結果 | URL が表示されることがある | Google がページを読んだ後は表示されない |
robots.txt と noindex を使い分けるときに押さえることは、以下の3つです。
- 検索結果から外したいページにはnoindexを使う
- 非公開のページはrobots.txtではなく認証で守る
- ページの表示に要るCSSやJavaScriptは止めない
検索結果から外したいページにはnoindexを使う
検索結果に出したくないページには、robots.txt ではなく noindex を使います。robots.txt で止めたページでも、ほかのページからリンクされていれば、Google はクロールせずに URL をインデックスに登録することがあります。その場合に検索結果に出るのは、説明文の無い URL です。
noindex は、ページの head に書く meta タグか、HTTP のレスポンス ヘッダーで伝えます。meta タグの書き方は、次の1行です。
<meta name="robots" content="noindex">noindex を書いたページは、robots.txt で止めてはいけません。robots.txt で止めると Google がページを読めず、noindex を見つけられないからです。robots.txt の中に noindex の行を書く方法にも、Google は対応していません。
非公開のページはrobots.txtではなく認証で守る
robots.txt は、アクセスを制限するしくみではありません。robots.txt に従うかどうかを決めるのは、クローラーの側です。Googlebot などの信頼できるクローラーは従いますが、ほかのクローラーも従うとは限りません。
robots.txt は、だれでもブラウザで読めるファイルです。見られたくないページのパスを Disallow に書くと、かえってページの場所を知らせることになります。会員向けのページや作業中のページは、パスワードなどの認証で守ります。
ページの表示に要るCSSやJavaScriptは止めない
画像やスクリプト、スタイルのファイルも robots.txt で止められますが、ページの表示に要るファイルは止めないようにします。止めると、Google がページを正しく読み取れず、適切に分析できなくなるためです。
Disallow にフォルダを書くときは、止めるフォルダの中にページの表示に使うファイルが入っていないかを確かめます。
AIのクローラーをrobots.txtで扱う方法
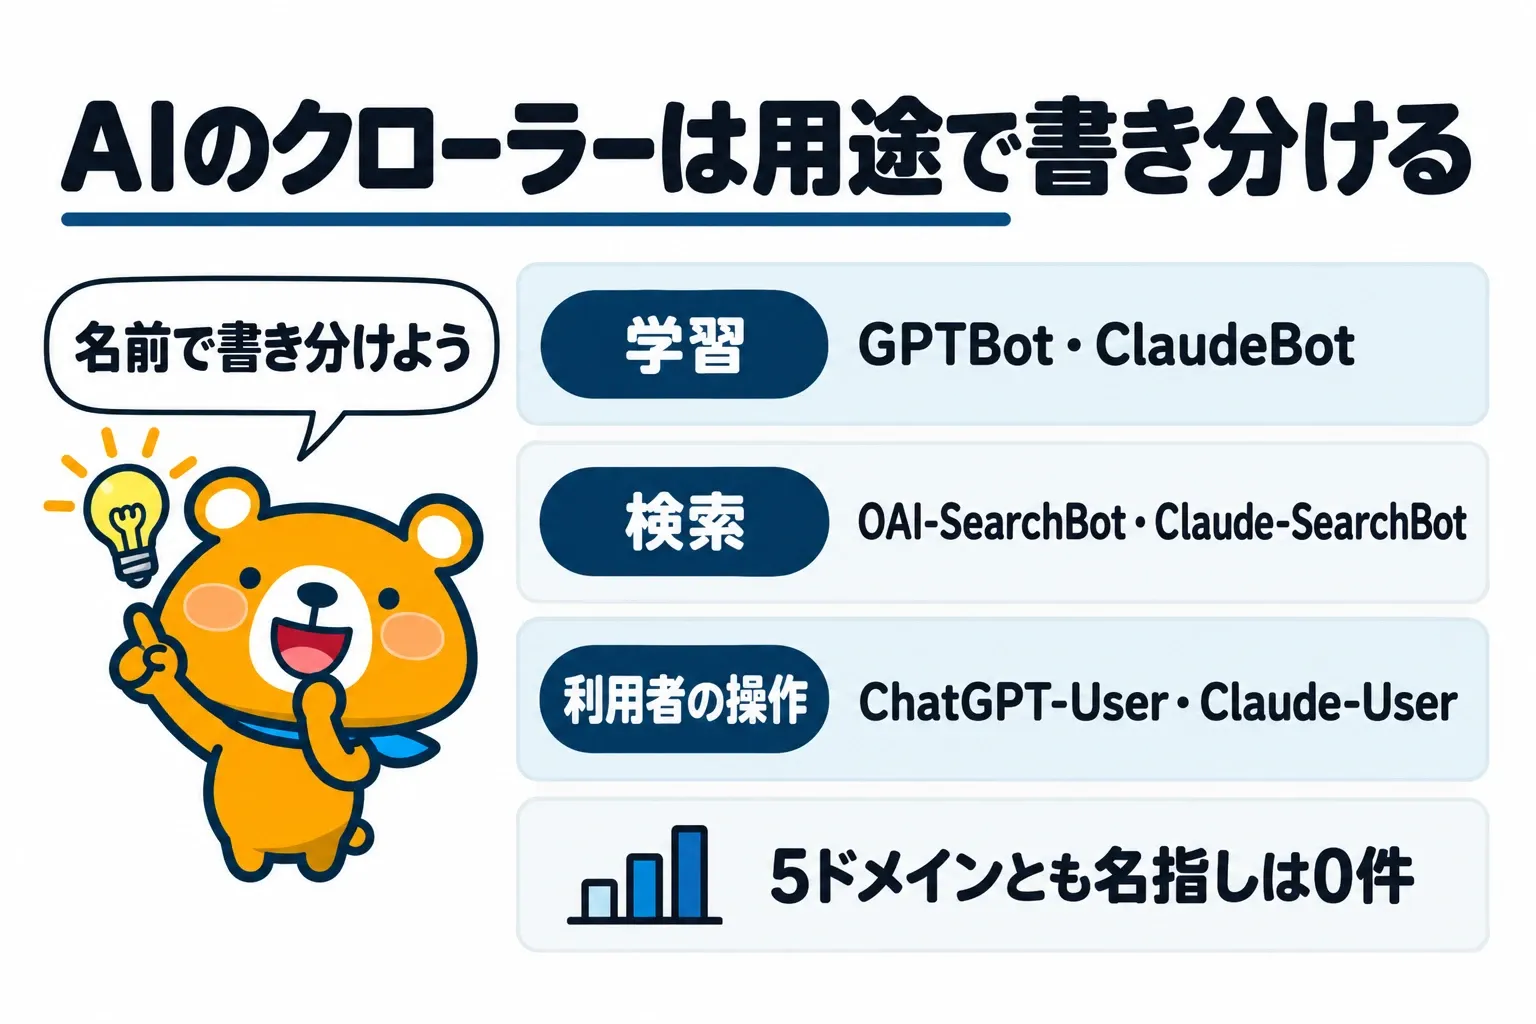
検索エンジンに加えて、生成 AI を提供する会社も robots.txt で扱えるクローラーの名前を公開しています。AI のクローラーを robots.txt で扱うときに確かめることは、以下の3つです。
- AIのクローラーの名前と用途を確かめる
- AIのクローラーを止めるときは用途ごとに名前を書く
- メリルの5ドメインでAIのクローラーを止めているかを数えた
AIのクローラーの名前と用途を確かめる
AI のクローラーは、学習に使うものと、検索や利用者の操作で動くもので名前が分かれています。2026年10月30日に各社の公式ページで確かめた名前と用途は、以下の表のとおりです。
| 会社 | robots.txt に書く名前 | 用途 |
|---|---|---|
| Google-Extended | Gemini のモデルの学習と、Gemini アプリなどのグラウンディングへの利用 | |
| OpenAI | GPTBot | 生成 AI の基盤モデルの学習 |
| OpenAI | OAI-SearchBot | ChatGPT の検索の結果への表示 |
| OpenAI | ChatGPT-User | ChatGPT の利用者の操作に応じたページの閲覧 |
| Anthropic | ClaudeBot | AI のモデルの学習 |
| Anthropic | Claude-SearchBot | 検索の結果の質の向上 |
| Anthropic | Claude-User | Claude の利用者の質問に応じたページの閲覧 |
Google-Extended は個別のクローラーを持たない名前で、Google 検索へのサイトの登録や検索の順位には影響しません。OpenAI の GPTBot と OAI-SearchBot の設定はそれぞれ独立しているため、ChatGPT の検索には表示させつつ、学習には使わせない設定もできます。
AIのクローラーを止めるときは用途ごとに名前を書く
AI のクローラーを止めるときは、止めたい用途のクローラーの名前でグループを作り、Disallow: / を書きます。GPTBot・ClaudeBot・Google-Extended の3つに Disallow: / を書き、ほかのクローラーには /wp-admin/ の下だけを禁止する場合の例は、次のとおりです。
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
名指ししたクローラーには * のグループのルールが当たらないため、3つのクローラーが読むのは Disallow: / のグループだけです。
設定の反映と効き方は、クローラーによって違います。
- OAI-SearchBot は、robots.txt を更新してから ChatGPT の検索に反映されるまで24時間ほどかかる
- ChatGPT-User は利用者の操作で動くため、robots.txt のルールが当たらない場合がある
- Anthropic のクローラーを止めるときは、止めたいサブドメインごとの robots.txt に書く
メリルの5ドメインでAIのクローラーを止めているかを数えた
メリルが2026年10月30日に、運営する5つのドメインの robots.txt を調べると、AI のクローラーを名指ししたドメインは0件でした。5つのドメインは、どれも User-agent: * のグループだけで書かれています。
robots.txt のルールに沿って判定すると、Google-Extended・GPTBot など7つの AI のクローラーは、5ドメインすべてでトップページ(/)のクロールを許可されています。
この集計は robots.txt の中身だけを見たもので、サーバーや CDN の設定での遮断は含みません。
AI のクローラーを止めるかどうかは、会社としての方針で決めることです。方針が決まったときにすぐ書けるよう、自社の robots.txt に今あるグループを確かめておきましょう。
robots.txtの書き方はクロールさせない場所だけを書き、公開後に確かめる
robots.txt は、User-agent のグループごとに、クロールさせないパスを Disallow で書くファイルです。検索結果から外したいページには noindex を使い、非公開のページは認証で守ります。
記事の要点は、以下のとおりです。
- robots.txtはドメインのルートに1つだけ置き、プロトコルとホストごとに効く
- 名指ししたクローラーには * のグループのルールが当たらない
- パスが最も長く一致したルールが使われ、同じ長さならAllowが使われる
- 検索結果から外すページはrobots.txtで止めずにnoindexを使う
- 公開後はブラウザ・robots.txtレポート・URL検査ツールで確かめる
- AIのクローラーは学習用・検索用など用途ごとの名前で書く
robots.txt は、ブラウザで URL を開くだけで中身を確かめられます。まずは自社のドメインのルートの robots.txt を開き、止めている場所が今のサイトに合っているかを確かめましょう。
この記事の数字の出どころ
- 株式会社メリルが運営する5つのドメインの robots.txt2026年10月30日14時00分〜14時01分に、5つのドメインの robots.txt を1回ずつ取得し、行の種類と数・AI のクローラーの名指しをスクリプトで数えた。AI のクローラー7種のクロールの可否は、RFC 9309 の決まりで判定した
- メリルのサイトの robots.txt の作りの記録meril.co.jp(Astro)の robots.txt を作るコードと、WWS メディア・Web集客ブックをドメインのサブディレクトリに置いたときの社内の作業記録
- blog-soudan.com の robots.txt レポートの画面2026年10月31日に Search Console(blog-soudan.com のプロパティ)の robots.txt レポートを開き、確認日時・ステータス・サイズを画面で読んだ。サーバーが返す robots.txt の大きさは同じ日に取得して測った
参考にしたページ
- robots.txt の書き方、設定と送信(Google のクロール インフラストラクチャ)(2026年10月30日に確認)
- Google による robots.txt の指定の解釈(Google のクロール インフラストラクチャ)(2026年10月30日に確認)
- 実用的な robots.txt のルール(Google のクロール インフラストラクチャ)(2026年10月30日に確認)
- robots.txt ファイルの更新(Google のクロール インフラストラクチャ)(2026年10月30日に確認)
- Google の一般的なクローラー(Google のクロール インフラストラクチャ)(2026年10月30日に確認)
- robots.txt の概要とガイド(Google 検索セントラル)(2026年10月30日に確認)
- noindex を使用してコンテンツをインデックスから除外する(Google 検索セントラル)(2026年10月30日に確認)
- サイトマップの作成と送信(Google 検索セントラル)(2026年10月30日に確認)
- robots.txt レポート(Search Console ヘルプ)(2026年10月30日に確認)
- URL 検査ツール(Search Console ヘルプ)(2026年10月30日に確認)
- RFC 9309: Robots Exclusion Protocol(RFC Editor)(2026年10月30日に確認)
- Overview of OpenAI Crawlers(OpenAI)(2026年10月30日に確認)
- Does Anthropic crawl data from the web, and how can site owners block the crawler?(Claude Help Center)(2026年10月30日に確認)
- do_robots()(WordPress Developer Resources)(2026年10月30日に確認)
- @astrojs/sitemap(Astro Docs)(2026年10月30日に確認)
運営:株式会社メリル(このメディアについて)。相談の内容を記事にするときは、ご本人の許可を取り、社名と数字を伏せます。