重複コンテンツの対策は本文で見つける|canonical・統合・書き分けの選び方
公開
記事が100本を超えたサイトでは、業界別や地域別に同じ型で書いた記事や、昔の記事の続きが並んでいることがあります。提携先への転載やメーカーの商品説明の掲載によって、同じ文が別のサイトに載っている場合もあります。
似たページが増えると重複コンテンツが気になりますが、タイトルが似ているだけでは重複とは言えません。この記事では、重複コンテンツの見つけ方と、重複の形ごとの対策の選び方を、株式会社メリルが自社のサイトで確かめた URL の応答や本文の重なりの数字とあわせて解説します。
記事を読めば、どのページをどの方法で直すかを決められます。重複コンテンツは、本文の重なりで見つけ、301・統合・書き分け・noindex のうち重複の形に合う方法で直すのが確実な対策です。
重複コンテンツはサーチコンソールと本文の比較で見つける
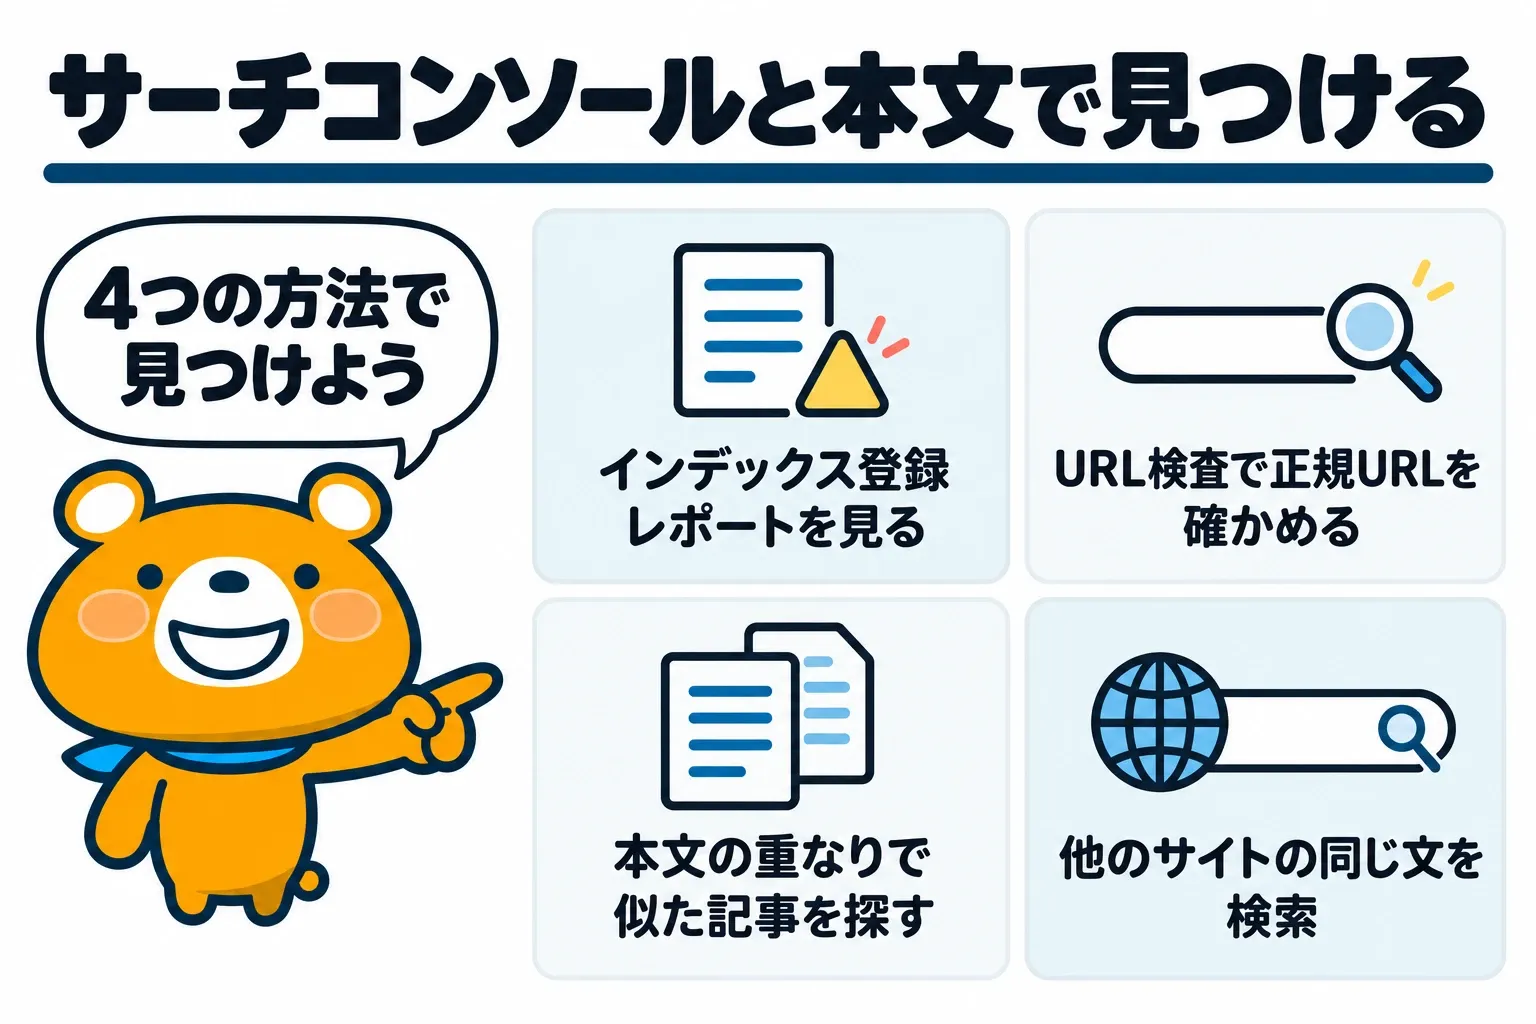
重複コンテンツには、自社のサイトの中で起きるものと、他のサイトとの間で起きるものがあります。サイトの中の重複はサーチコンソールと本文の比較で、他のサイトとの重複は検索で探します。
重複コンテンツを見つける方法は、以下の4つです。
- インデックス登録レポートで重複の理由が付いたページを見る
- URL検査でGoogleが選んだ正規URLを確かめる
- タイトルではなく本文の重なりで似た記事を探す
- 他のサイトに同じ文が載っていないかを検索で確かめる
インデックス登録レポートで重複の理由が付いたページを見る
サイトの中の重複は、サーチコンソールの「ページのインデックス登録」レポートで最初に確かめます。Google が重複と判断したページには、インデックスに登録されなかった理由として、重複を示す名前が付くためです。
重複と正規ページに関係する主な理由は、以下の表のとおりです。
| 理由の名前 | 意味 |
|---|---|
| 重複していますが、ユーザーが正規ページとして選択していません | 他のページと重複していて、正規ページの指定が無い。Google は別のページを正規ページに選び、このページは検索結果に出ない |
| 重複しています。Google により、ユーザーがマークしたページとは異なるページが正規ページとして選択されました | canonical で正規ページと指定したが、Google は別の URL を正規ページとして登録した |
| 代替ページ(適切な canonical タグあり) | AMP ページやモバイル版など、別のページの代替として正しく指定されている。対処は要らない |
レポートで理由の行を選ぶと、その理由に当てはまる URL の一覧が表示されます。一覧に並ぶのがパラメータ付きの URL か、別々に書いた記事かを見れば、重複の形の見当が付きます。
URL検査でGoogleが選んだ正規URLを確かめる
レポートで見つけた URL は、URL 検査で1本ずつ、Google がどのページを正規ページとして扱っているかを確かめます。URL 検査の結果には「ユーザーが指定した正規 URL」と「Google が選択した正規 URL」が並び、自社の指定と Google の判断を見比べられます。
URL 検査で正規 URL を確かめる手順は、以下のとおりです。
- サーチコンソールの画面の上部にある検査の欄に、開いているプロパティの URL を https:// から入れる
- 結果の「ユーザーが指定した正規 URL」で、ページの canonical の指定を見る
- 結果の「Google が選択した正規 URL」で、Google が正規ページに選んだ URL を見る
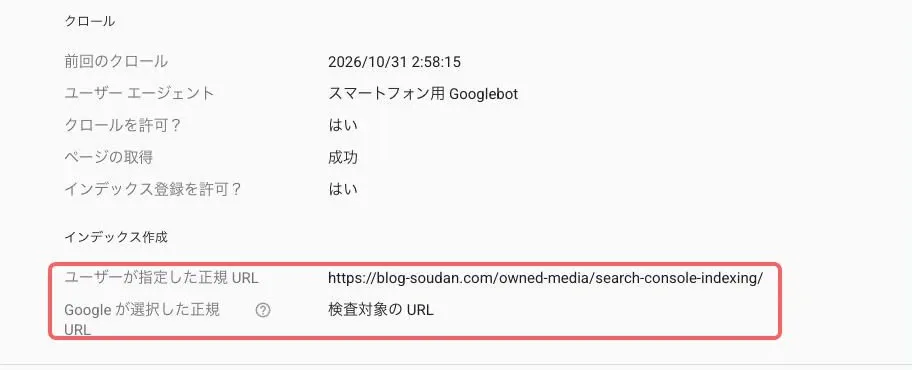
出典:Google Search Console のURL 検査ツール(オウンドメディア相談室が使っている blog-soudan.com のプロパティ。2026年10月31日の画面)。調べたのはこのメディアの記事の URL です。Google Search Console は Google LLC の商標です。オウンドメディア相談室は、Google が推奨・提携しているものではありません。
2つの URL が同じなら、ページは自社の指定どおりに扱われています。違う場合は、Google が別の URL のほうを正規ページとして適切と判断した状態です。
Google が選んだ正規 URL は、「公開 URL をテスト」ではなく、インデックスに登録されたデータで確かめます。公開 URL のテストでは、テストしたページが正規ページになるかを予測できないからです。
タイトルではなく本文の重なりで似た記事を探す
サーチコンソールに重複の理由が出る前に似た記事を探すなら、タイトルではなく本文を比べます。タイトルが似ていても本文は記事ごとに書かれていることがあり、反対に、タイトルが違っても本文の大部分が同じ記事もあるからです。
本文を比べる方法は、以下の2つです。
- 同じ文の数: 2本の記事を句点で文に分け、1文字も違わない文がいくつあるかを数える
- 5文字の重なり: 本文を5文字ずつずらして切り出し、2本に共通する組の割合を0〜1で表す
同じ文の数は、文章をそのまま使い回した箇所を見つけるのに向いています。5文字の重なりは語尾や語順を少し変えた文も拾うため、記事の多いサイトで候補を絞るときに使えます。
記事が多いサイトでは、本文を取り出してスクリプトで全部の組み合わせを数えると漏れがありません。数える前に、別々に書いた記事どうしでどのくらいの値になるかを知っておくと、ほかより大きく外れた組を見つけやすくなります。
メリルが、オウンドメディア相談室の記事21本の全210組を2026年10月30日に数えた結果は、以下の表のとおりです。
| 比べたもの | 結果 |
|---|---|
| 5文字の重なりの平均 | 0.033 |
| 5文字の重なりの最大 | 0.082 |
| 5文字の重なりが0.1以上の組 | 0組 |
別々に書いた記事どうしでも、よく使う言い回しが共通するため、5文字の重なりは0になりません。21本では、最も小さい組でも0.021でした。同じ文の数も、どの記事にも入る決まった言い回しを拾うため、決まった言い回しを除いてから比べます。
他のサイトに同じ文が載っていないかを検索で確かめる
他のサイトに自社の文が載っていないかは、記事の中の特徴のある1文を引用符で囲み、Google で検索すると確かめられます。単語やフレーズを引用符で囲むと、完全に一致するものが検索されます。
他のサイトとの重複を検索で確かめる手順は、以下のとおりです。
- 記事の中から、自社の数字や固有の言い回しを含む1文を選ぶ
- 選んだ文を "" で囲んで Google で検索する
- 自社以外のドメインのページが出たら、開いて転載の範囲を確かめる
どのサイトにもある言い回しで検索すると関係のないページまで一致するため、自社の数字を含む文を選ぶと転載を見つけやすくなります。同じ文が自社のサイトの中に何ページあるかを調べたいときは、検索する語の前に site:example.com のように自社のドメインを付けると、そのドメインのページだけが表示されます。
サイトの中の重複コンテンツの対策は重複の形で選ぶ
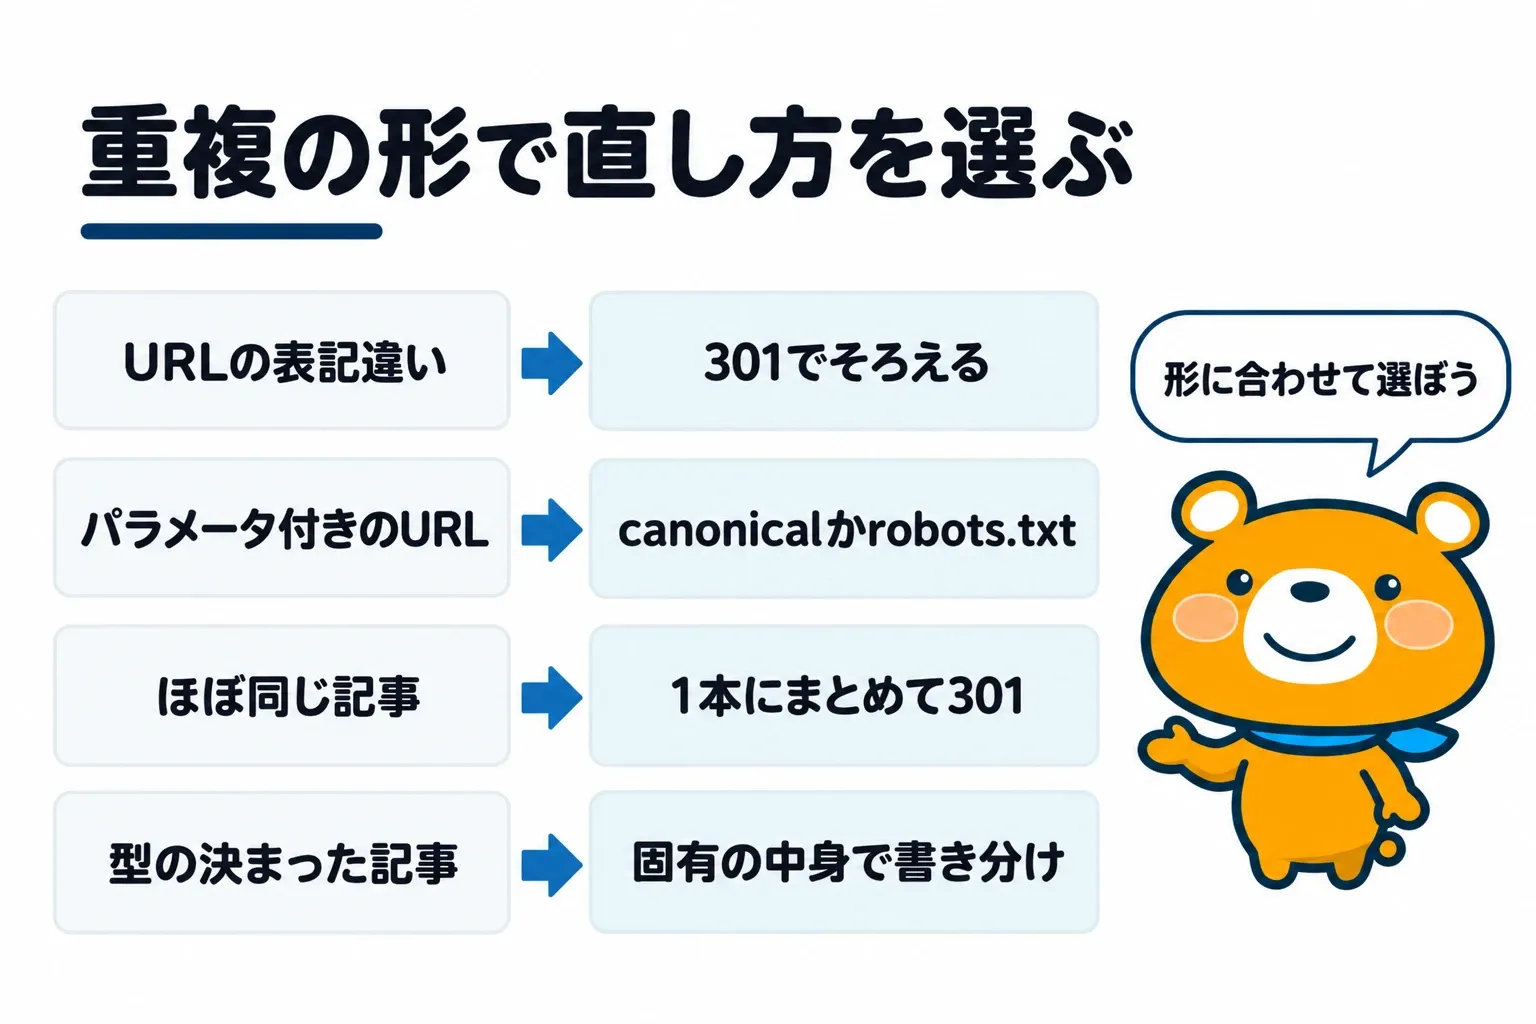
サイトの中で重複コンテンツが生じること自体は、Google のスパムに関するポリシーの違反ではありません。Google は重複したページから1つを正規ページに選び、ほかのページを正規ページより低い頻度でクロールします。
対策の目的は、検索結果に出したいページを Google に正規ページとして選ばせることです。サイトの中の重複の形と直し方は、以下の4つに分かれます。
- URLの表記違いは301でひとつの形にそろえる
- パラメータ付きのURLはcanonicalかrobots.txtで扱いを決める
- 中身がほぼ同じ記事は1本にまとめて301で転送する
- 型の決まった記事は記事ごとに固有の中身を書き分ける
URLの表記違いは301でひとつの形にそろえる
http と https、www の有無、末尾の / の有無だけが違う URL で同じページが開けるなら、URL の形を1つに決め、ほかの形から301で転送します。リダイレクトは、転送先が正規ページになるべきことを強く示すシグナルです。
表記違いで同じページが開けてしまう URL の例は、以下のとおりです。
- http://example.com/page と https://example.com/page
- https://www.example.com/page と https://example.com/page
- https://example.com/page と https://example.com/page/
同じ内容の HTTP と HTTPS のページがあると、Google は HTTPS のページを優先して正規 URL に選びます。ただし、SSL 証明書が無効な場合などは例外です。
メリルの会社サイト(meril.co.jp)は、https・www 無し・末尾の / 無しの形に URL をそろえています。2026年10月30日に、会社案内のページを4通りの URL で1本ずつ開いた結果は、以下の表のとおりです。
| 開いた URL | 応答 | 転送先 |
|---|---|---|
| https://meril.co.jp/company | 200 | なし(canonical は自身の URL) |
| https://meril.co.jp/company/ | 301 | /company |
| http://meril.co.jp/company | 301 | https://meril.co.jp/company |
| https://www.meril.co.jp/company | 301 | https://meril.co.jp/company |
表記違いの3つの URL は、どれも1回の301で、canonical と同じ URL に移りました。確かめるときは、転送をたどらずに最初の応答を見て、転送先が正規の URL そのものになっているかを確かめます。
» htaccessのリダイレクトの書き方|301の設定例と確かめ方・注意点
パラメータ付きのURLはcanonicalかrobots.txtで扱いを決める
商品の一覧を並べ替えたり、色や価格で絞り込んだりする機能は、?sort=price のようなパラメータを付けた URL を作ります。組み合わせの数だけ似た URL が増えると、クローラーが役に立たない URL に時間を使い、新しいページの発見が遅れることがあります。
検索結果に出す必要があるかどうかで分けた、パラメータ付きの URL の扱い方は以下のとおりです。
- 検索結果に出す必要がない: robots.txt でパラメータ付きの URL のクロールを禁止し、絞り込みの無い一覧と個々の商品のページだけをクロールさせる
- 正規の URL を示したい: パラメータ付きの URL に rel="canonical" を付け、正規の URL を示す
robots.txt はクロールを止める設定のため、検索結果に出したい URL を選ばせる目的には使いません。絞り込みの URL を検索結果に出す場合は、パラメータの区切りに & を使い、結果が0件になる組み合わせには404を返します。
サーチコンソールの URL パラメータ ツールは、2022年3月28日に、1か月後の提供終了が告知されました。パラメータの扱いは Google のクローラーが自動で学習するため、ツールに代わる設定は要りません。細かく制御したいときは、robots.txt のルールを使います。
中身がほぼ同じ記事は1本にまとめて301で転送する
同じ読者に向けて同じことを書いた記事が2本あるなら、1本にまとめます。残す記事に足りない内容を移し、残さない記事の URL から残す記事の URL へ301で転送する方法です。
2本の記事を1本にまとめる手順は、以下のとおりです。
- 2本の表示回数・クリック数・被リンクを並べ、実績の多いほうを残す記事に決める
- 残さない記事にしか無い内容を、残す記事に書き足す
- 残さない記事の URL から、残す記事の URL へ301で転送する
- サイト内のリンクを、残す記事の URL に張り替える
2本が同じ検索語で表示を取り合っている場合の、残す記事の選び方と転送の向きの決め方は、以下の記事で取り上げました。
» カニバリのSEO対策は1検索語に1ページ|サーチコンソールでの見つけ方と直し方
型の決まった記事は記事ごとに固有の中身を書き分ける
重複コンテンツは中身がほぼ同じページのことで、業界別・地域別のように見出しの型が同じというだけでは当てはまりません。重複になるのは、業界名や地域名を入れ替えただけで、本文の大部分が同じ記事です。
検索キーワードを含んでいても閲覧者にとってほとんど意味がないページを大量に作ることは、Google のスパムに関するポリシーで、大量生成されたコンテンツの不正使用の例に挙がっています。型の決まった記事を書き分ける方法は、以下のとおりです。
- その業界・地域にしか当てはまらない事例や数字を入れる
- その業界・地域の読者に固有の悩みと答えを書く
- どの記事にも共通する説明は1本の記事にまとめ、各記事からリンクする
書き分けたあとも、Google が重複のまとまりからページを分けるまでに、最長で2週間かかる場合があります。新しい中身とほかのページとの違いが大きいほど、ページは早く分けられます。
他のサイトと同じ文があるときの重複コンテンツの対策
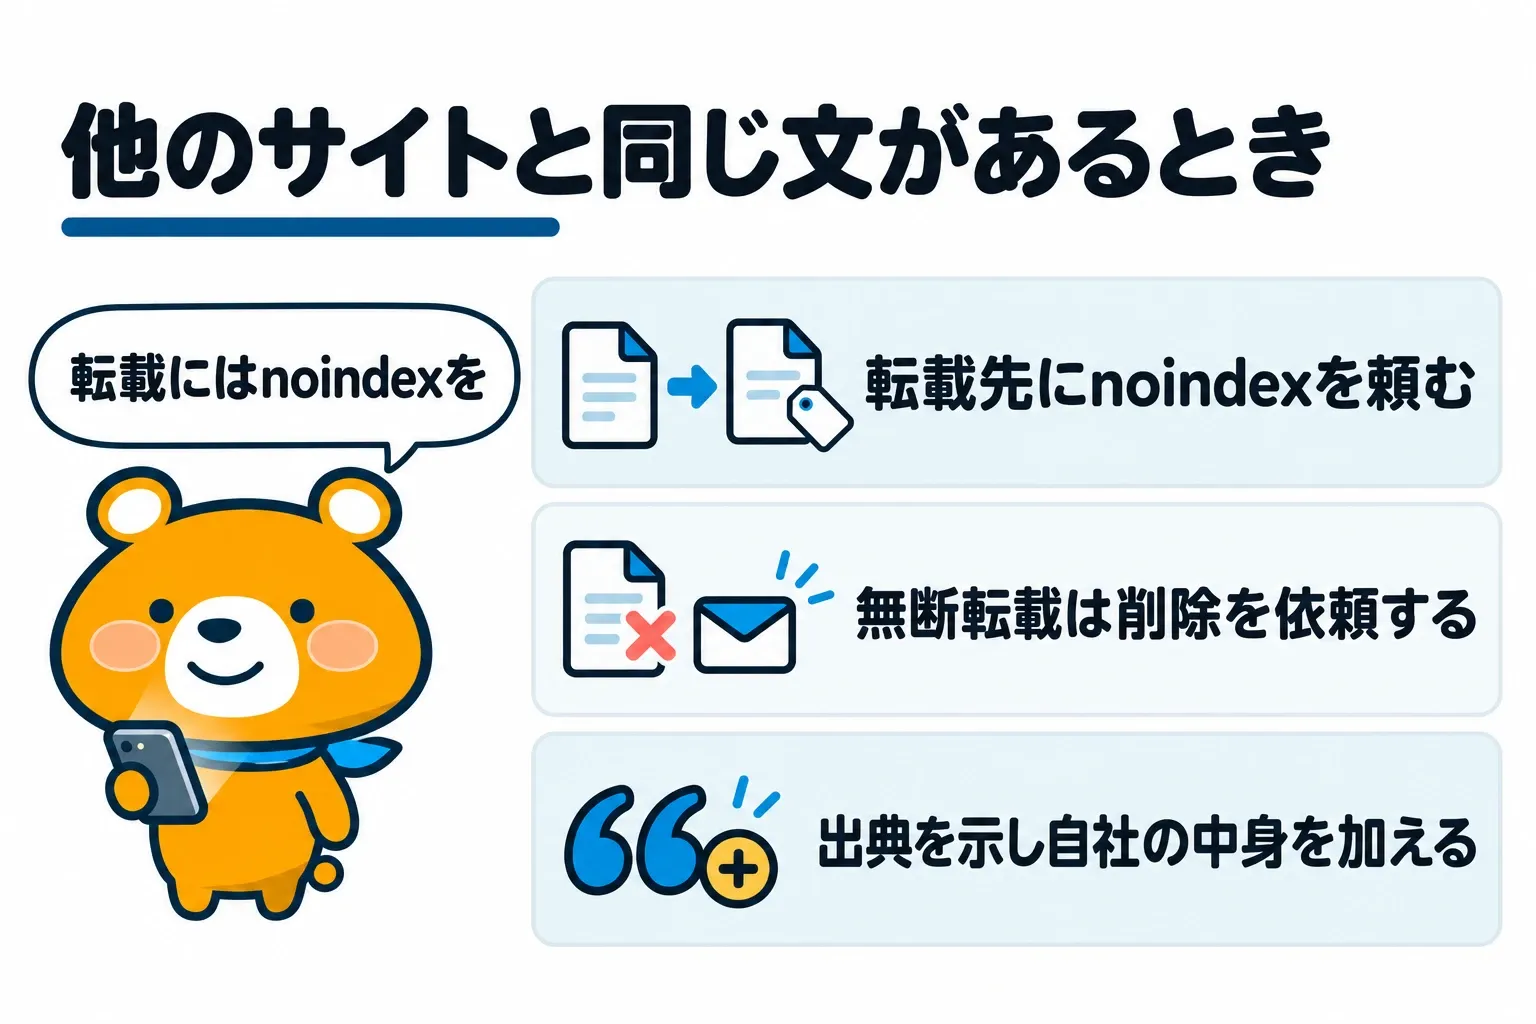
他のサイトとの間の重複は、自社が許して転載したもの、無断で転載されたもの、自社が他のサイトの文を使ったものの3つに分かれます。他のサイトとの重複への対策は、以下の3つです。
- 記事を転載してもらうときは転載先にnoindexを頼む
- 無断で転載されたら運営者に削除を頼み、Googleに申し立てる
- 他のサイトの文を使うときは出典を示し、自社の中身を加える
記事を転載してもらうときは転載先にnoindexを頼む
提携先のメディアに自社の記事を転載してもらうときは、転載先のページに、検索結果に出さない設定(noindex)を付けてもらいます。転載先との重複を避けるには、canonical の指定ではなく、転載先でインデックスへの登録を止めてもらう方法が最も効果的です。
転載を頼む前に、転載先と取り決めておくことは以下のとおりです。
- 転載先のページに noindex を付けてもらう
- 転載する範囲(全文か一部か)
- 転載先のページから元の記事へリンクしてもらう
以前の転載で canonical の指定を頼んでいた場合は、noindex への切り替えを頼みます。
無断で転載されたら運営者に削除を頼み、Googleに申し立てる
自社の記事が無断で転載されていたら、まず転載先のサイトの運営者に削除を頼みます。まれに、無断で転載した外部のサイトの URL が、Google に正規ページとして選ばれることもあります。
無断転載に気づいたときの手順は、以下のとおりです。
- 転載先のページの URL と、転載された範囲を記録する
- 転載先のサイトの問い合わせ窓口から、削除を依頼する
- 運営者が応じない場合は、Google に著作権侵害による削除を申し立てる(DMCA に基づく通知)
正規 URL に選ばれたのが転載先の URL だと、そのページの検索のトラフィックは、自社のサーチコンソールでは確認できません。
他のサイトの文を使うときは出典を示し、自社の中身を加える
メーカーの商品説明や取引先の発表文を自社のページに載せるときは、元の文を並べるだけのページにしないことが大切です。元のページを示さず、独自の中身も加えずに他のサイトの内容を転載することは、Google のスパムに関するポリシーで「スクレイピング」の例に挙がっています。
語句を類義語に置き換えたり、自動化された手法を使ったりして若干の修正を加えた転載も、同じ例に入っています。文末を変えただけ、言い換えただけの文章は、独自の中身とは言えません。
他のサイトの文を使うページに加える中身は、以下のとおりです。
- 元のページの名前と URL
- 自社で試した結果や、自社の顧客に当てはめた説明
- 元の文には無い比較や手順
重複コンテンツを増やさないためにURLと記事の決まりをそろえる
重複コンテンツは、あとから直すより、増やさない決まりを先に作るほうが手間がかかりません。URL の形と canonical の出し方をテンプレートで決めておけば、記事が増えても同じ形が保たれるからです。
重複を増やさないために決めておくことは、以下の3つです。
- canonicalは自身のURLを絶対パスで出す
- URLの形をcanonical・サイト内のリンク・サイトマップでそろえる
- 新しい記事を書く前に既存の記事の本文を確かめる
canonicalは自身のURLを絶対パスで出す
canonical は、重複したページだけでなく、正規ページ自身にも付けます。rel="canonical" の URL は、相対パスではなく、https:// から始まる絶対パスで書きます。
オウンドメディア相談室は、すべての記事の head に、記事自身の URL を canonical として出す作りにしました。canonical はページの共通の枠が記事の URL から自動で作るため、記事を足しても書き忘れが起きません。
<link rel="canonical" href="https://blog-soudan.com/owned-media/cannibalization/">canonical を付けるときに避ける指定は、以下のとおりです。
- 正規化のために robots.txt でクロールを止める
- 正規ページを選ばせるために noindex を付ける
#から後ろの部分(URL フラグメント)を含む URL を正規 URL にする
noindex を付けたページは Google 検索から完全に外れるため、重複したページのどれを残すかを決める手段には向きません。
» robots.txtの書き方|記述例と置く場所・確かめ方、noindexとの違い
URLの形をcanonical・サイト内のリンク・サイトマップでそろえる
末尾に / を付けるかどうかは、サイトごとにどちらに決めても構いません。大切なのは、決めた形を canonical・サイト内のリンク・サイトマップのすべてでそろえることです。リダイレクト・canonical・サイトマップのように正規 URL を示す方法は、組み合わせて使うほうが効果的だからです。
メリルの会社サイトとオウンドメディア相談室は、末尾の / の扱いを反対に決めています。meril.co.jp は / を付けない形で、/ を付けた URL は / の無い URL へ301で転送しています。オウンドメディア相談室は / を付ける形で、canonical・サイト内のリンク・サイトマップの URL をすべて / 付きで出力しました。
新しい記事を書く前に既存の記事の本文を確かめる
サイトの中の重複は、同じテーマの記事があることを知らずに書き足したときや、ほかの記事の文章を別の記事に入れたときに生まれやすくなります。オウンドメディア相談室では、重複コンテンツとカニバリを別々の記事にする前に、この記事は中身がほぼ同じページ、カニバリの記事は同じ検索語で表示を取り合うページ、と扱う範囲を分けました。2本の本文の5文字の重なりは0.057で、同じ文は1つもありませんでした。
新しい記事を書く前に確かめることは、以下のとおりです。
- 同じテーマの記事がサイトの中にあるか
- ある場合、新しい記事の読者と狙う検索語が今の記事と違うか
- 型の決まった記事なら、その記事にしか無い事例や数字があるか
ほかの記事の手順を使いたくなったときは、手順を1本の記事にまとめ、使いたい記事からリンクします。
重複コンテンツの対策は本文で見つけて形に合う方法で直す
重複コンテンツは、タイトルの近さではなく、本文の重なりとサーチコンソールの正規 URL で見つけます。本文の重なりは、自社の記事どうしのふつうの値と比べて、大きく外れた組から開いて確かめます。
重複コンテンツの対策の要点は、以下のとおりです。
- サイトの中の重複は、インデックス登録レポートと URL 検査で確かめる
- 記事どうしの重複は、同じ文の数と5文字の重なりで本文を比べる
- URL の表記違いは301、パラメータ付きの URL は canonical か robots.txt で扱う
- ほぼ同じ記事は1本にまとめ、型の決まった記事は固有の中身で書き分ける
- 転載には noindex を頼み、無断転載は削除を依頼する
- 重複の整理に noindex と robots.txt を使わない
重複の形に合う方法を選べば、検索結果に出したいページを Google に正規ページとして選ばせやすくなります。まずはサーチコンソールのページのインデックス登録レポートを開き、重複の理由が付いた URL が何本あるかを確かめましょう。
この記事の数字の出どころ
- meril.co.jp の URL の表記違いの応答2026年10月30日に、会社案内のページを https・末尾の / 付き・http・www 付きの4通りの URL で1本ずつ開き、応答の番号・転送先・canonical を確かめた結果
- オウンドメディア相談室の記事の本文の重なり2026年10月30日時点の記事21本の全210組を、5文字ずつの重なりでスクリプトで比べた
- オウンドメディア相談室の canonical と URL の形このメディアのサイトの設定(記事の URL から canonical を作る仕組み・末尾の / ・サイトマップ)を2026年10月30日に確かめた結果
参考にしたページ
- rel="canonical" などを利用して正規 URL を指定する方法(Google 検索セントラル)(2026年10月30日に確認)
- 正規化とは(Google 検索セントラル)(2026年10月30日に確認)
- 正規化に関する問題の修正(Google 検索セントラル)(2026年10月30日に確認)
- Google ウェブ検索のスパムに関するポリシー(Google 検索セントラル)(2026年10月30日に確認)
- ファセット ナビゲーション URL のクロール管理(Google 検索セントラル)(2026年10月30日に確認)
- 春のクリーンアップ: URL パラメータ ツール(Google 検索セントラル ブログ、2022年3月28日)(2026年10月30日に確認)
- ページのインデックス登録レポート(Search Console ヘルプ)(2026年10月30日に確認)
- URL 検査ツール(Search Console ヘルプ)(2026年10月30日に確認)
- Google 検索の結果を絞り込む(Google 検索ヘルプ)(2026年10月30日に確認)
運営:株式会社メリル(このメディアについて)。相談の内容を記事にするときは、ご本人の許可を取り、社名と数字を伏せます。